Aller au contenu
SKU PROJ-008 · Release 2026 · Version de travail
Ma façon
de builder
FRIDA Méthode Design system
FRIDA, c'est ma méthode pour passer d'un irritant à un produit vraiment utilisé. Cinq étapes, une question à chacune, et une règle pour finir : Kill or Keep. L'IA produit vite, je garde le jugement.
5
étapes, une question à chacune : c'est FRIDA
25
composants dans Matteo DS, en clair et en sombre
1
règle pour finir : Kill or Keep
Fiche technique
- Rôle
- Auteur, et premier utilisateur.
- Statut
- Version de travail, mise à jour à chaque build.
- Sources
- Mon terrain chez Yeita, le double diamant, F.O.C.U.S.E.D de Thiga.
- Outils
- Claude Code, Notion, Figma, shadcn/ui, Geist.
- Indicateurs suivis
- Pour chaque produit : est-ce utilisé, et la douleur a-t-elle baissé ?
- Pour qui
- Les équipes produit qui buildent avec l'IA.
Le constat
Avec l'IA, on sort un prototype en une heure. Le vrai problème n'est plus de produire : c'est de relire tout ce qu'on produit, et de livrer des choses qui servent. Dans l'étude Faros AI (2025, plus de 10 000 développeurs, étude d'éditeur), les équipes fusionnent presque deux fois plus de pull requests et passent 91 % de temps en plus en review, sans gain mesuré pour l'entreprise. Ce qui limite un produit aujourd'hui, c'est le temps qu'un humain a pour vérifier et décider. FRIDA est construite autour de cette limite.
FRIDA, étape par étape
Cinq étapes, toujours dans le même ordre. À chacune : une question, un livrable précis, et un coup de main de l'IA. Le nom se retient comme un prénom, et c'est fait exprès.
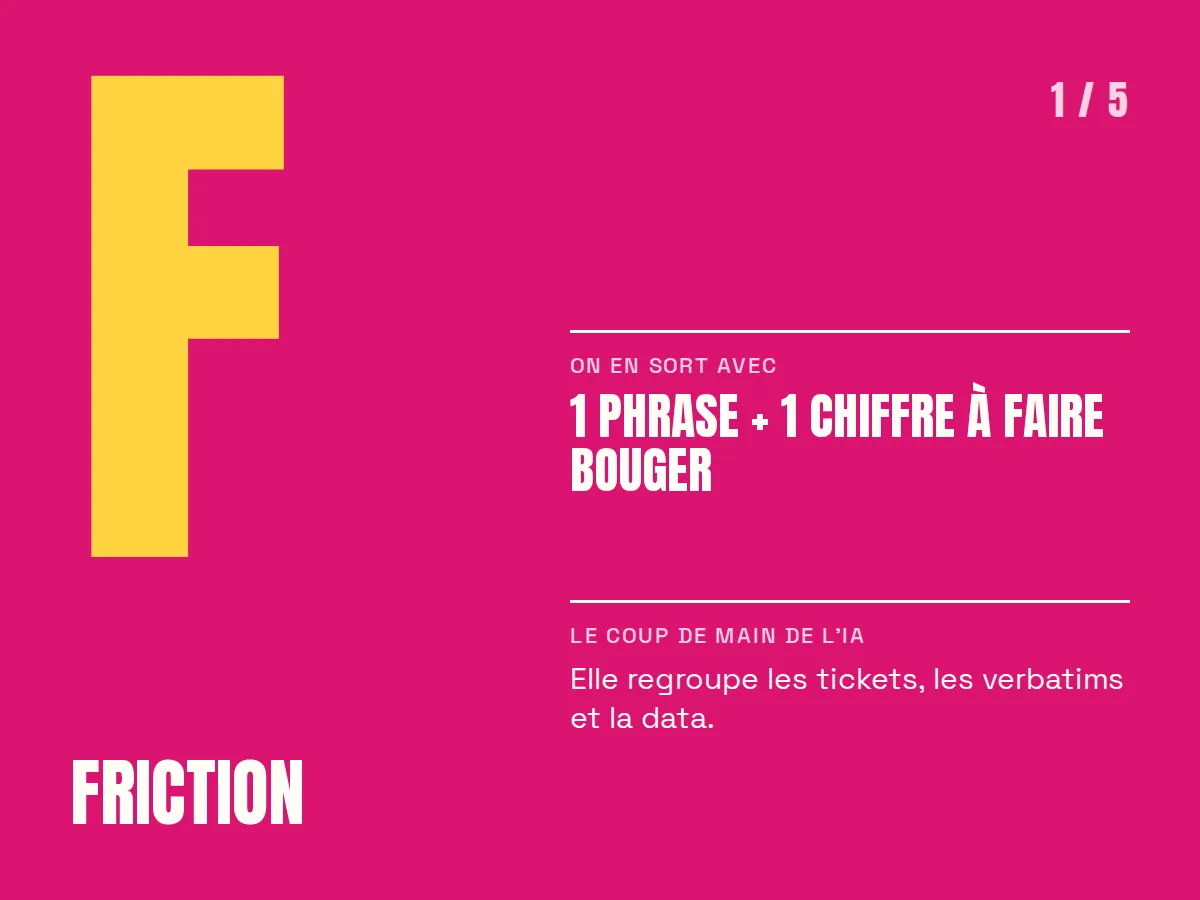
01 Friction : partir d'une vraie douleur
La question : qui a mal, quand, et combien ça coûte ? À ce stade, je ne cherche pas de solution. Je cherche un irritant, observé chez de vraies personnes. L'IA regroupe les tickets, les verbatims et la data pour faire ressortir ce qui revient le plus. J'en sors avec une phrase et un chiffre à faire bouger.
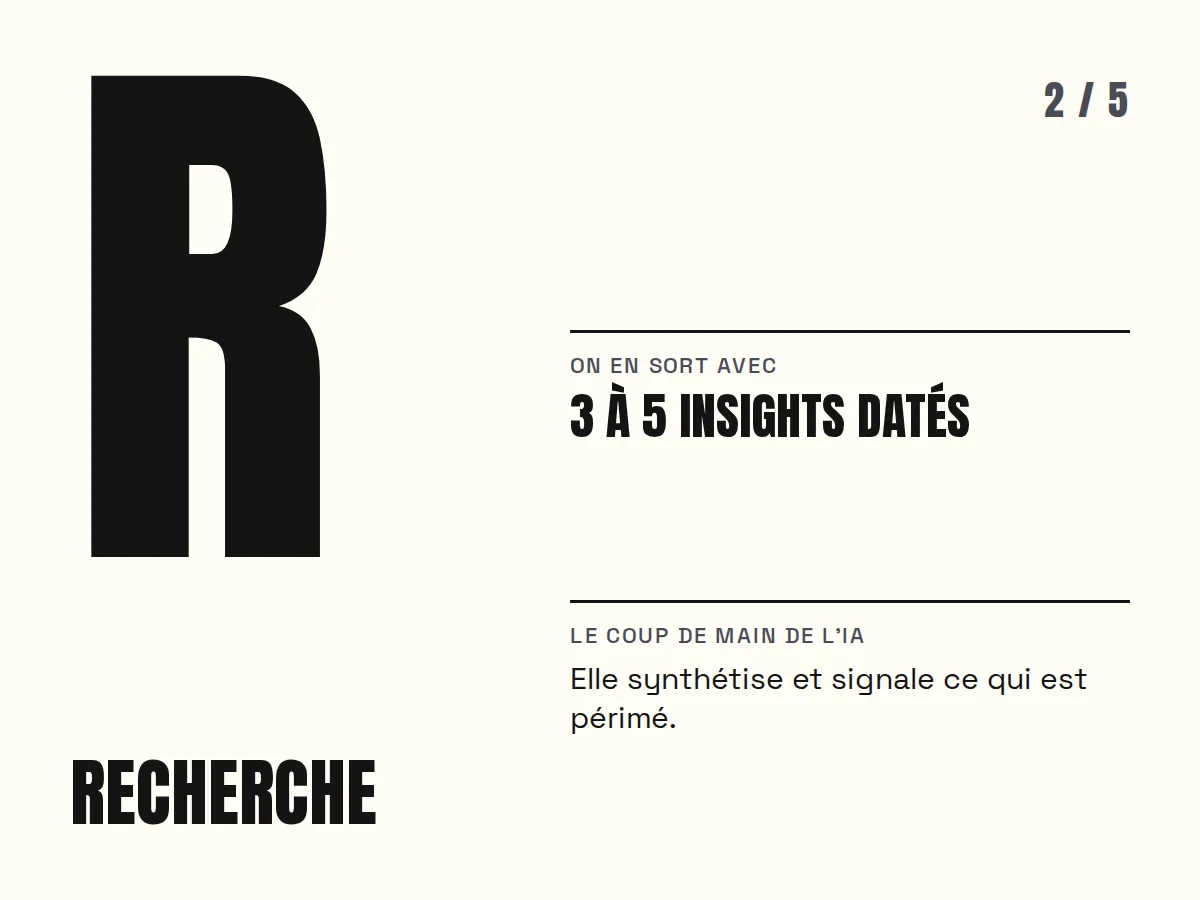
02 Recherche : ce qui est vrai aujourd'hui
La question : qu'est-ce qu'on sait d'aujourd'hui, et pas d'il y a un an ? Les usages changent vite, et les études vieillissent aussi vite. L'IA synthétise ce qu'on a et signale ce qui est périmé. J'en sors avec 3 à 5 insights, chacun avec sa date.
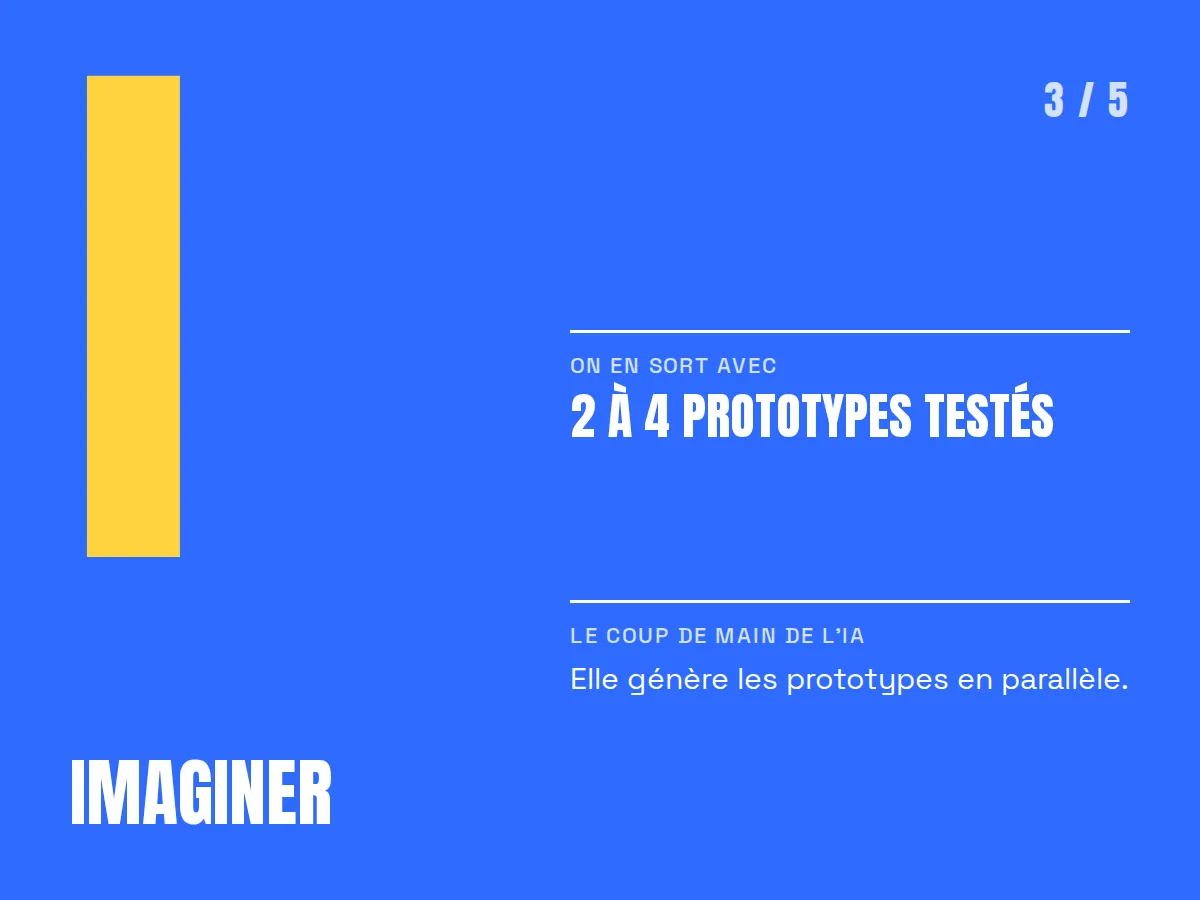
03 Imaginer : plusieurs pistes, testées pour de vrai
La question : quelles solutions tester pour de vrai ? L'IA génère plusieurs prototypes en parallèle, là où on en dessinait un seul. J'en montre 2 à 4 à des utilisateurs, et ce sont eux qui départagent.
04 Double review : est-ce bon, puis est-ce correct ?
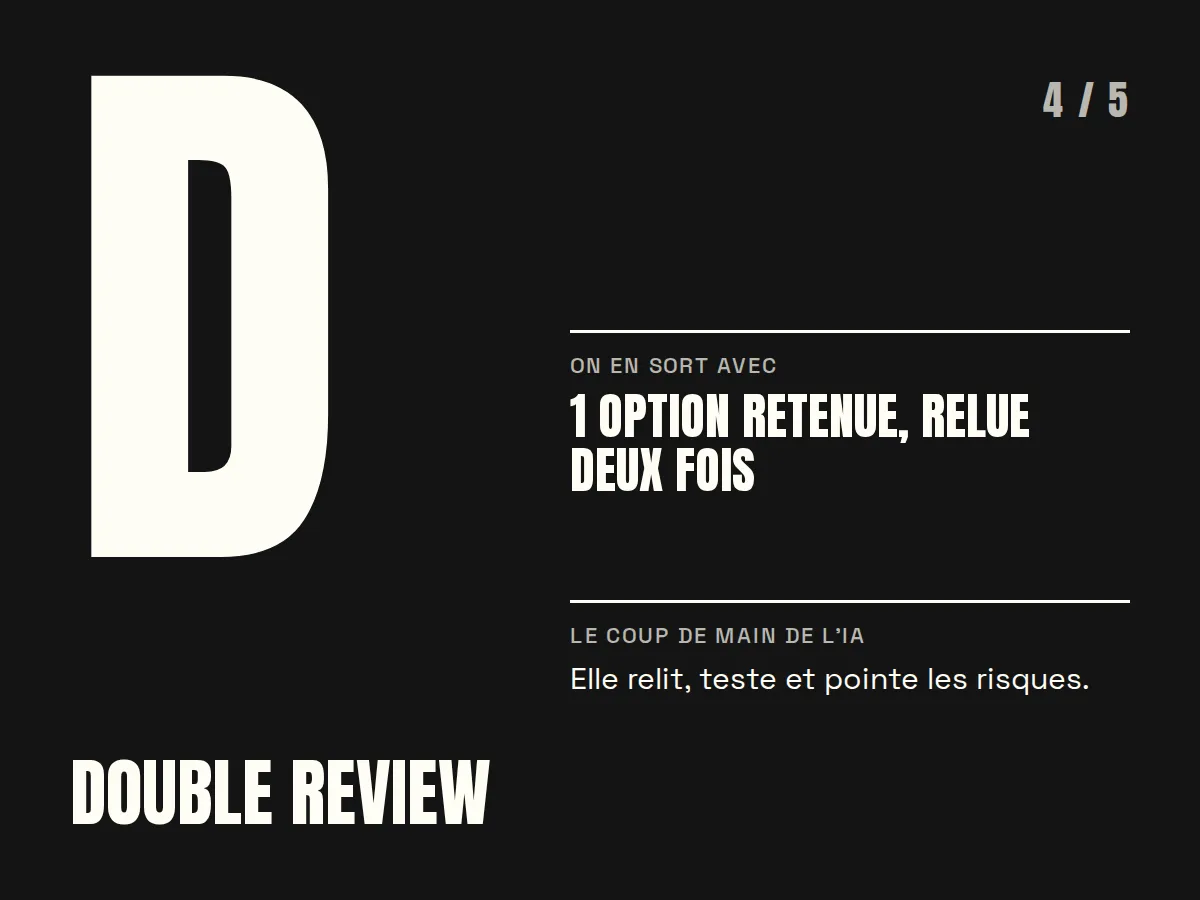
C'est l'étape qui compte le plus quand l'IA produit à ta place. Première relecture : est-ce que c'est bon ? Des pairs critiquent la solution, y compris des gens d'autres squads. Deuxième relecture : est-ce que c'est correct ? L'IA relit, teste et pointe les risques, puis le code est vérifié. J'en sors avec une seule option retenue.
05 Adoption : Kill or Keep
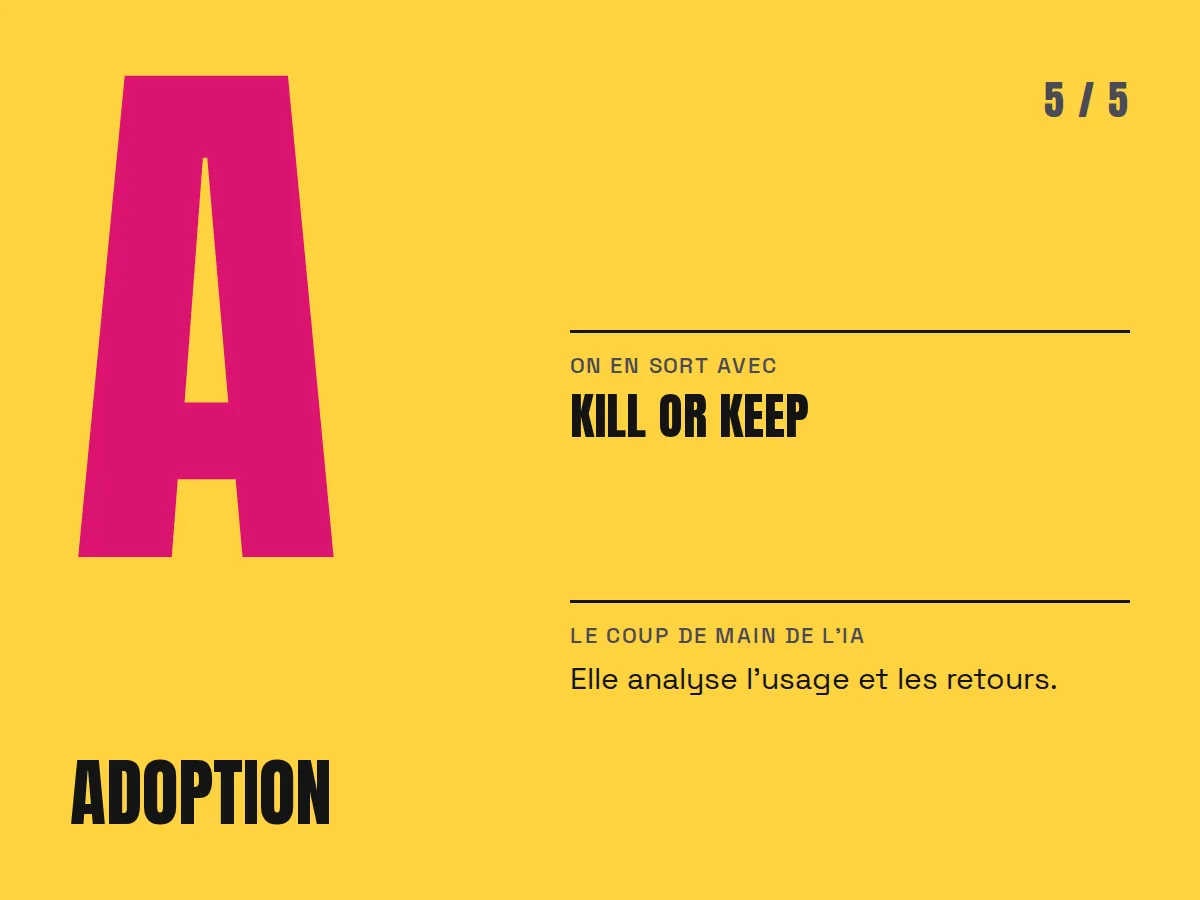
La question : est-ce utilisé, et la douleur a-t-elle baissé ? Je reviens au chiffre de départ. L'IA analyse l'usage et les retours. Puis on tranche : on garde ce qui sert, on arrête le reste. Un produit que personne n'utilise ne mérite pas d'être maintenu.
Mes outils pour builder
01 Matteo DS, mon design system
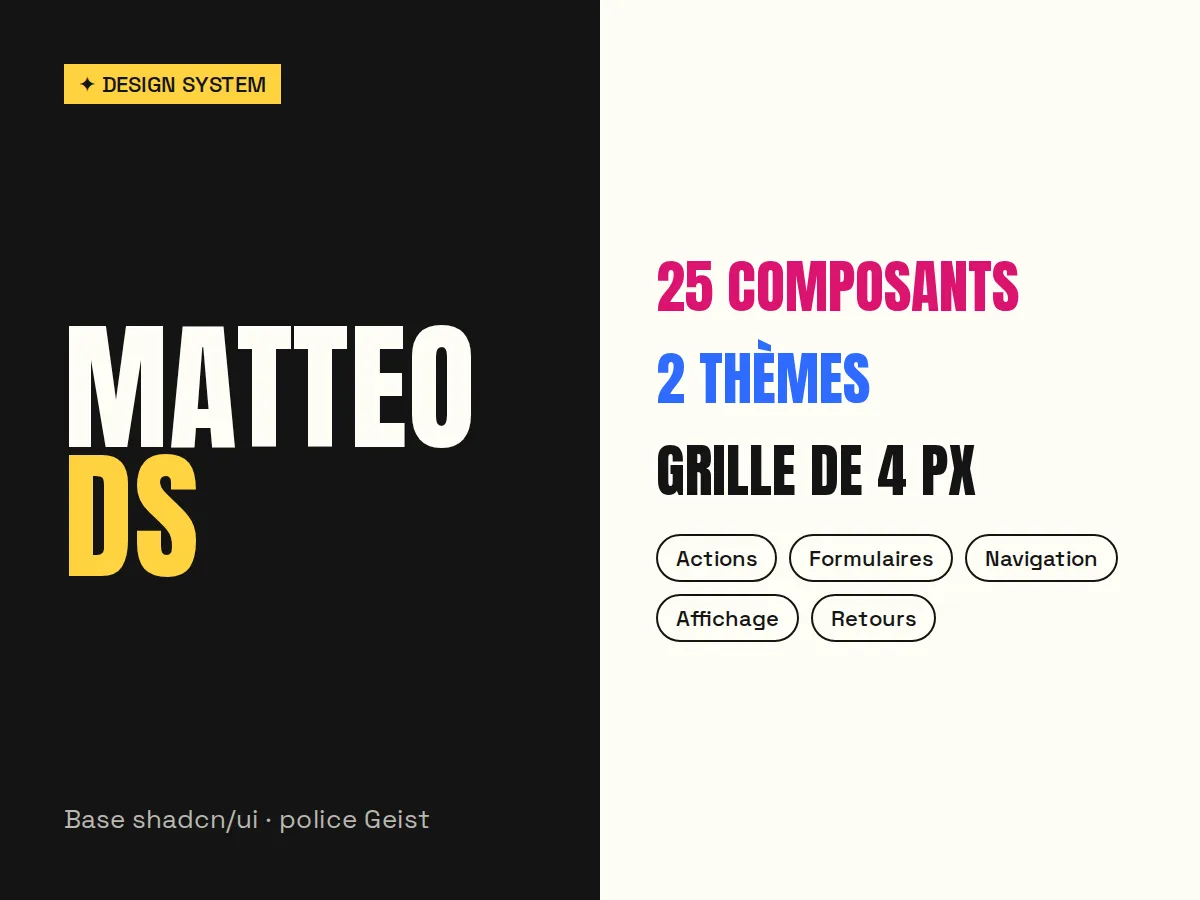
Quand une IA génère des écrans, les produits finissent par tous se ressembler. J'ai donc construit mon propre design system : 25 composants, deux thèmes, une grille de 4 px, sur une base shadcn/ui avec la police Geist, et une documentation complète. L'IA assemble mes composants au lieu d'inventer les siens.
02 Les données au centre
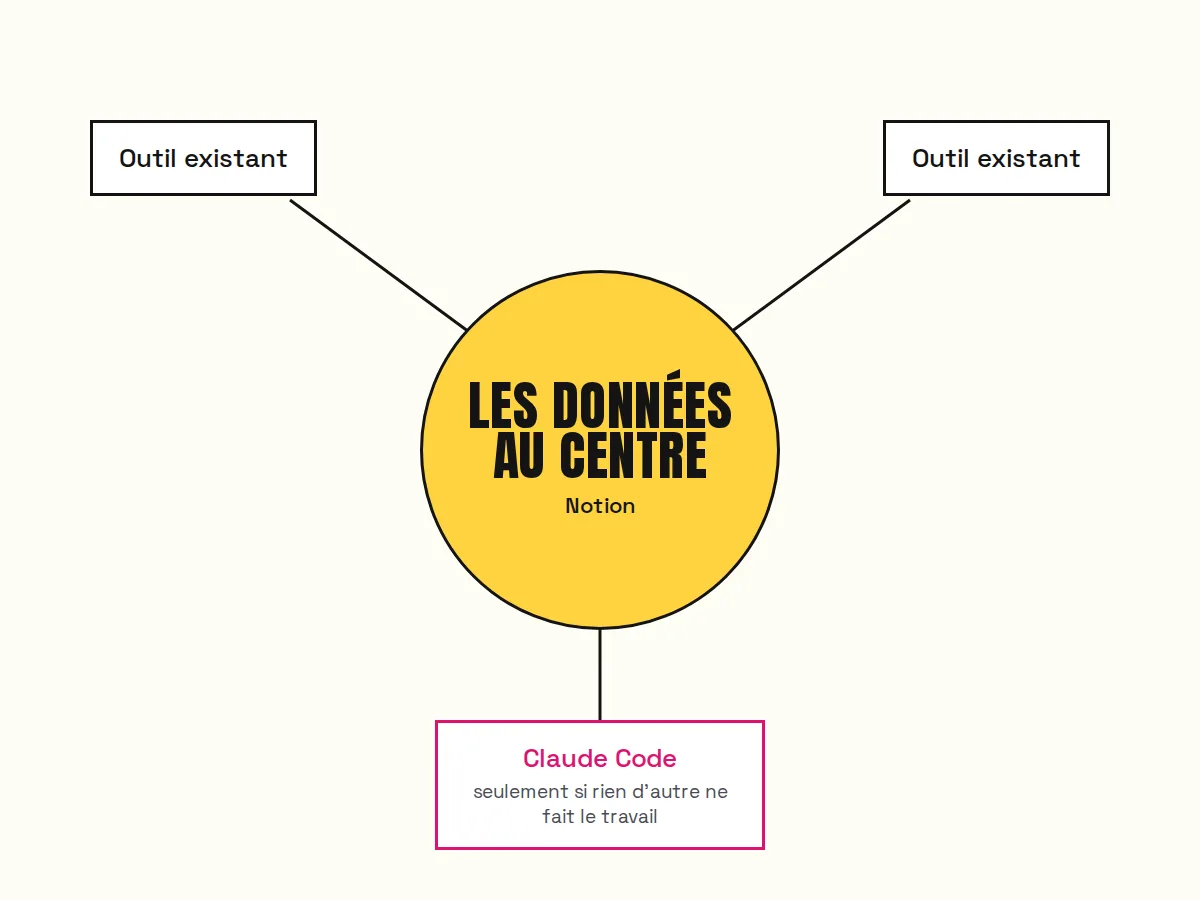
Je centralise les données dans Notion et je branche les outils dessus. Avant, je fabriquais un petit outil avec Claude Code à chaque besoin, et aucun ne parlait aux autres. Aujourd'hui, Claude Code ne sert que quand aucun outil existant ne fait le travail.
En cours
Trois chantiers que je mène en ce moment avec le cercle IA de Yeita. Rien n'est fini : je montre où ça en est.
Les harnais d'agents
Un harnais, c'est le cadre qu'on donne à un agent IA pour qu'il travaille proprement : ses sources, ses outils, ses règles. Le nôtre part d'un référentiel UX (personas, insights, parcours, backlog) et propose des maquettes dans Figma à partir d'un insight.
Où ça en est : en test sur un jeu de données fictif.
Les mini-produits
Des petits produits internes pour apprendre en construisant : un onboarding gamifié pour les nouveaux arrivants, et un démonstrateur où Notion sert de référentiel central, avec Claude et ses connecteurs comme interface unique.
Où ça en est : en cadrage et en construction.
User et data centric
Chaque démonstrateur suit le même fil : on part d'un insight utilisateur, on le centralise, on designe, on livre, on mesure, et la mesure revient dans le référentiel. Une maquette doit pouvoir remonter à un insight, et un produit à un chiffre.
Où ça en est : le parcours est défini, la mesure du temps gagné reste à faire.
Où j'en suis
FRIDA est une version de travail. Elle vient de mon terrain chez Yeita et de méthodes existantes (le double diamant, F.O.C.U.S.E.D de Thiga). Elle n'a pas encore été appliquée de bout en bout sur un produit utilisé par d'autres : c'est la prochaine étape. Je publierai ici les résultats, les bons comme les mauvais.